从零训练到真板运行: 我们怎样把中文模型放进 ESP32
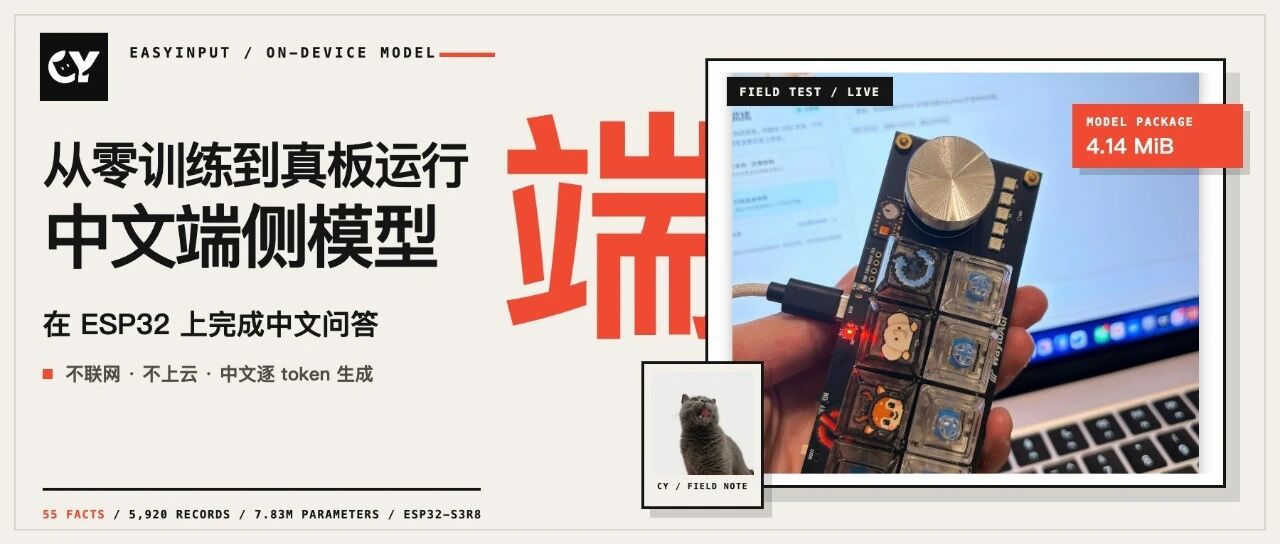
本文完整记录了在资源极度受限的ESP32-S3开发板上,从零训练并部署一款783万参数中文模型的全过程。面对仅8MB PSRAM与16MB Flash的硬件瓶颈,团队首先明确垂直问答边界,精心整理近六千条高质量原子事实数据。通过引入量化感知训练策略,采用Q4权重与int8激活技术,成功将模型体积压缩至4.14MiB。随后基于C语言独立构建包含中文分词、注意力机制与逐Token生成的完整运行时环境。最终实现通过USB直连本地网页,在完全离线状态下完成稳定推理,为边缘设备端侧AI落地提供了清晰可复用的全链路工程方案。