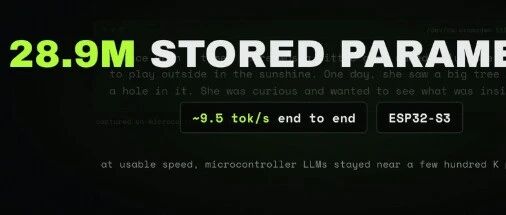
974 分登顶 HN、5 天 769 星、28.9M 参数、在一个 8 美元的 ESP32-S3 上——这串数字放在一起,第一反应大概是"你在开玩笑吧"。
但我没有。这就是 slvDev 做的 esp32-ai 项目。
这事有多离谱?
先帮你建立一下认知框架。你平时跑一个 Llama 3 8B,需要大概 16GB 显存——也就是一张 RTX 4060 起步。你跑一个 Qwen 2.5 7B GGUF,需要至少 4GB 可用内存。
而 ESP32-S3 呢?
-
售价:约 8 美元(批量价可能更低)
-
SRAM:512KB(你没看错,是 KB,不是 MB,更不是 GB)
-
Flash:16MB
-
CPU:240MHz 双核 Xtensa LX7
在 512KB 的内存里跑一个 28.9M 参数的神经网络?数学上就不对——28.9M 个参数,就算每个参数只占 1 个字节,那也是 28.9MB,是可用 RAM 的 57 倍。
那他是怎么做到的?
怎么做到的?权重量化到极致
答案其实不复杂,但对"正常"的 AI 开发者来说有点反直觉:
|
你在 GPU 服务器上做的 |
slvDev 在 ESP32 上做的 |
|---|---|
|
FP16/BF16 精度 |
4-bit 量化 — 每个参数只占 0.5 字节 |
|
参数全部常驻 VRAM |
参数存储在 Flash 里,按需调入 |
|
一次性加载整个模型 |
逐层推理,用完一层丢掉一层 |
|
GPU 并行计算 |
单核串行计算 |
|
Linux + CUDA |
裸机 C 代码,无操作系统 |
最关键的是:这个模型不是从零训练的。它基于一个已有的小模型做极致的 4-bit 量化,然后烧录到 ESP32 的 Flash 里。推理时,微控制器逐层从 Flash 读取权值到 SRAM,计算完一层再读下一层。
输出速度?一个字大概要 1-2 秒。但考虑到这是在一个 8 块钱的芯片上运行的,这已经像个魔术了。
而且它是完全离线的。不连 WiFi,不上云,不发送任何数据——你的对话文本全部在芯片内部处理完毕。
实际怎么用?
# 这不是示例代码——这是它真实的 API
from esp32_ai import ESP32AI

ai = ESP32AI(device='/dev/ttyUSB0')
response = ai.generate("你好,我是谁?")
print(response)
当然,实际体验和 ChatGPT 差距巨大——毕竟这是一个在微控制器上跑的语言模型。每次推理要等几秒,能处理的上下文有限,生成质量远不如大模型。
但在一些特定场景下,它恰好够用:
- 智能家居
:不需要把语音指令发到云端分析,本地处理完毕
- 教育玩具
:给孩子的 AI 玩具,不需要联网,没有隐私风险
- 物联网终端
:在传感器节点上做基本的自然语言交互
- 离线助手
:野外作业、军用、偏远地区——不需要互联网就能用的基本 AI 能力
HN 上的讨论
HN 评论区(238 分)有赞也有质疑。支持者的核心观点是"这是嵌入式 AI 的里程碑"——证明了即使是最便宜的微控制器也能运行现代语言模型,这对于 IoT 和边缘计算意义深远。
质疑者的意见也很直接:"生成质量够用吗?""实用性有多高?"毕竟你用一个 4090 上的 Llama 3 得到的是流畅的多轮对话,而 ESP32 上得到的是逐字慢慢蹦出来的短回复。
还有人提出了更实际的问题:ESP32-S3 的 QSPI Flash 带宽有限,逐层读取的延迟可能是真正的瓶颈——而不是计算本身。
意味着什么?
esp32-ai 不是一个"把 ChatGPT 装进你的 ESP32"的奇迹,它更像是 AI 计算的"极限运动"——告诉世界:在这条成本曲线上,我们还能往下走多远。
8 块钱。28.9M 参数。本地运行。这三件事放在一起,本身就是一件值得记录的事情。
你会用它来跑什么?或者说——下一个问题是:如果我们能在 8 块钱的芯片上跑 28M 参数的模型,那么在 50 块钱的芯片上能跑什么?这个市场的想象力才刚刚打开。