FIELD NOTE / 2026
从零训练到真板运行:
我们怎样把中文模型放进 ESP32
BUILD LOG · AUG 2026
hello 啊,我是 CY。
最近一起在玩 EasyInput这个开发板。
做了一些相关的案例。然后呢,突然有一天想到。能不能给它放进去一个端侧的模型。
没想到真的成了。把过程记录一下,和大家分享。
一块只有 8 MB PSRAM、16 MB Flash 的 ESP32-S3,能不能离线运行一个真正会逐词生成答案的中文模型?我们用一套从随机参数开始训练的 783 万参数模型,完成了从产品知识、训练、量化到真板运行的整条链路。
本地网页连接真实开发板后的运行界面:电脑只负责 USB 传输与显示。
|
783 万 可训练参数 |
4.14 MiB 完整板端模型包 |
1.5–2.25 秒 真板生成完整回答 |
我们把这条已经走通的工程路径完整拆开:怎样把产品知识整理成数据,怎样训练一个符合芯片资源的模型,怎样把它压缩成板子装得下的形式,再怎样用 C 语言让它在 ESP32 上独立完成中文分词、推理和逐 token 生成。
面对资源有限的设备,第一反应往往是把一个大模型尽量压小。真正开始做之后,我们发现更关键的一步发生在训练之前:先把“它需要解决什么问题”说清楚。模型大小、数据组织、训练方法和部署方式,都要围绕这个边界共同设计。
01
先看结果:模型已经在真板上回答中文问题
目前,用户可以在本地网页输入中文问题,问题通过 USB 发送到开发板。板上的 Tokenizer 把文字转换成数字,模型在板上逐 token 生成答案,再通过 USB 把结果传回网页。电脑只负责传输和显示,不保存答案表,也不代替板子做推理。
当网页里出现第一段由开发板逐 token 返回的中文答案时,前面的数据、训练、量化和 C 语言运行时才真正连成了一件事:这个答案确实来自那块小小的板子。
真板演示:开发板通过 USB 与本地网页连接,中文问题的分词、推理和逐 token 生成都在板上完成。
一次真实板端问答:首 token 181 ms,总耗时 1,518 ms,输出 20 tokens。
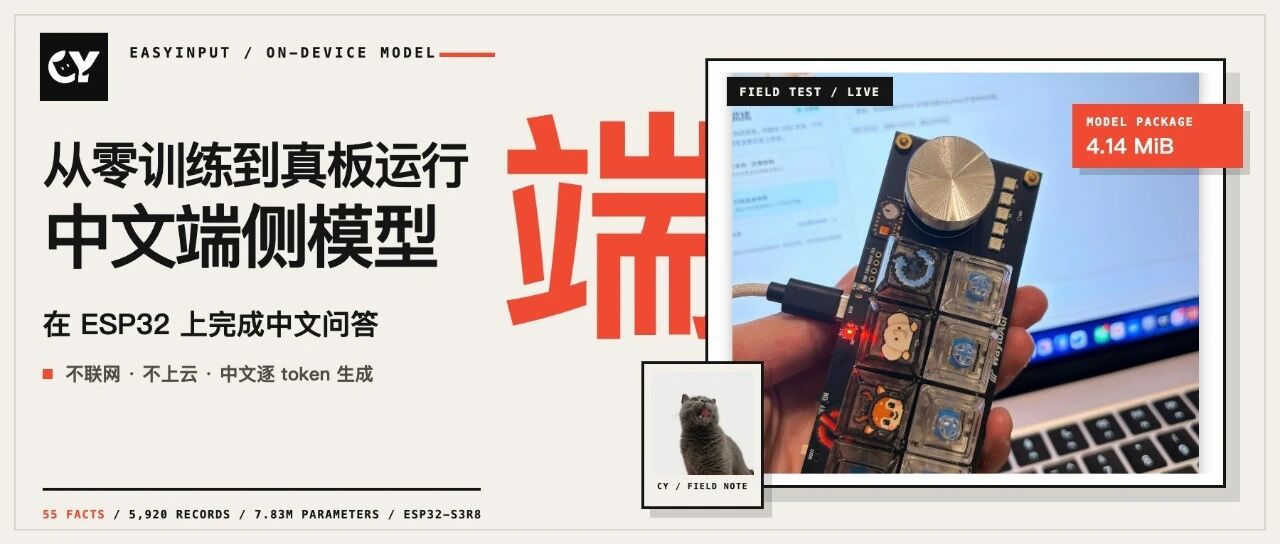
正在运行当前模型的 EasyInput 开发板实物。
|
观察项 |
真板结果 |
|
芯片与存储 |
ESP32-S3R8,8 MB PSRAM,16 MB Flash |
|
模型初始化后的 PSRAM 余量 |
约 5.42 MB |
|
运行频率 |
CPU 240 MHz,双核并行运行正常 |
|
首个 token 延迟 |
约 123–473 ms |
|
交互方式 |
USB 真板问答与本地网页界面均可使用 |
当前状态说明:这是开发验证版本,现有 41 项质量检查通过 34 项。剩余 7 项主要集中在少量问题的语义分流、量化差异和答案结束稳定性。它已经能用于真板体验,也清楚地告诉了我们下一轮训练该改什么;完成全部质量检查后,才会进入正式发布阶段。
02
小芯片上的模型,先从边界开始
“端侧模型”指的是直接运行在设备一侧的模型。它不依赖云端服务器完成核心推理,因此可以离线工作,响应路径更短,数据也不必为了得到答案而离开设备。
当前 EasyInput V2.0 开发板正面部件说明:电源、USB-C、8 个机械按键、旋钮、RGB、麦克风孔、BOOT、状态灯、调试触点与固定柱。
把通用大模型直接压小,通常无法解决端侧设备真正面对的资源问题。ESP32 的内存、算力和存储都很有限,更适合先做好一个边界清楚的任务。我们选择的是中文单轮垂直问答:模型只围绕当前 EasyInput 开发板回答问题,内容聚焦当前硬件,也不承担开放世界聊天。
开始整理数据前,我们先回答了三个问题:
1这块设备必须知道哪些事实?
2用户可能用哪些方式询问这些事实?
3哪些问题应该正常回答,哪些问题应该要求澄清或明确超出范围?
这三个问题看起来简单,却决定了后面的模型规模和训练难度。边界越清楚,有限的参数越能用在真正需要的能力上。
03
把产品知识变成可以训练的数据
我们先把当前开发板的资料整理成 55 条“原子事实”。原子事实是一条尽量只表达一件事、能够单独检查对错的知识,例如某个接口的用途、某个操作的步骤,或者某项能力的边界。
每条事实先对应一份规范答案,再扩展成多种真实问法。用户可能说“这个接口做什么”,也可能说“这里应该接什么”或“为什么没有反应”。模型需要理解这些表述指向同一个事实,而不是只记住一种固定句式。
|
数据组成 |
数量 |
作用 |
|
基础问答 |
4,664 条 |
覆盖 55 条原子事实及其常见问法 |
|
补充问法 |
608 条 |
补足更自然、更口语化的表达 |
|
语义对照数据 |
648 条 |
帮助模型区分看起来相似、答案却不同的问题 |
|
合计 |
5,920 条 |
共同构成当前训练数据 |
这 5,920 条记录围绕 55 条可靠事实展开,从不同角度教模型理解、区分和表达。数据量增加的是问法、对照和表达路径,而不是未经核验的知识。
同一模型对问候、麦克风和扬声器问题的真实板端回答。
04
中文怎样变成模型能处理的数字
神经网络不能直接读取汉字,它处理的是整数编号。把文字切成若干最小处理单位并映射成编号的工具,叫作 Tokenizer;切出来的每个单位,叫作 token。
01输入“开发板怎么连接”,Tokenizer 把文字切成 token。
02每个 token 被转换成一个整数 ID,模型在这些数字上进行计算。
03模型生成新的 ID,再由 Tokenizer 还原成可以显示的中文。
我们的 Tokenizer 是一套确定性的中文切分规则:同一句话在 Python 训练程序和 C 语言板端运行时里,必须得到完全相同的 token ID。规范数据需要保持有效 UTF-8,编码后再解码要能无损还原,也不能因为未知 token 而丢失信息。
项目使用两套词表:输入词表有 6,400 个 token,输出词表有 4,096 个 token。输入侧需要覆盖更多可能的问法;输出侧只保留答案真正需要生成的内容,从而减少最后一层计算和权重。输出 token 还会映射回输入词表,让已经生成的内容可以继续参与下一步预测。
05
一个 783 万参数的小模型长什么样
这里说的“参数”,就是模型在训练中不断调整并最终保存下来的数字。当前模型共有 7,834,112 个参数,采用 Decoder-only Transformer,按顺序一个 token 接一个 token 地生成文本,直到输出结束标记。Transformer 可以理解为一套让模型在上下文中寻找关联、组合信息并预测下一个 token 的结构。
每一层都包含注意力机制和前馈网络。注意力机制帮助模型判断问题中哪些 token 更重要;前馈网络负责进一步变换和组合这些信息。我们还使用 RoPE 表示 token 在句子中的相对位置,并使用 SwiGLU 形式的前馈网络提升有限参数下的表达能力。
PLE 是 Per-Layer Embeddings 的缩写,可以理解为“每一层自己的辅助记忆表”。普通词向量告诉模型“这个 token 是什么”,PLE 则让不同层在处理同一个 token 时获得不同的补充信息。前面的层可以更关注文字和局部结构,后面的层可以更关注答案选择与生成。
|
结构项 |
当前设置 |
|
输入词表 / 输出词表 |
6,400 / 4,096 |
|
隐藏维度 |
128 |
|
Transformer 层数 |
6 层 |
|
注意力头数 |
4 头 |
|
前馈网络维度 |
384 |
|
PLE 维度 |
128 |
|
上下文 / 最长答案 |
128 / 32 token |
|
参数总量 |
7,834,112 |
06
模型怎样从随机参数学会回答
这次训练从随机初始化开始,没有加载外部预训练权重。模型最初的 7,834,112 个参数都是随机数,它对 EasyInput 一无所知。训练的过程,就是让这些随机参数在一次次问答练习中逐渐形成稳定的预测规律。
一条问答怎样变成一次练习
训练样本会被组织成“问题 + 答案”的 token 序列,并加入表示开始和结束的特殊 token。训练时,模型每走一步都尝试预测答案中的下一个 token。我们只在答案区域计算误差,不要求模型复述问题。
训练还会采用 teacher forcing:预测下一个 token 时,给模型看到前面正确的答案 token。这样学习过程更稳定,也能让模型清楚地知道每一步应该接什么。
模型怎样根据错误调整自己
预测结果与正确答案之间的差距会被计算成一个数值,这就是损失。随后,反向传播会找出每个参数对这次错误产生了多大影响,AdamW 优化器再沿着减小损失的方向更新参数。不断重复“预测、计算损失、反向传播、更新参数”,模型才从随机状态逐渐学会回答。
|
训练设置 |
当前数值 |
|
训练记录 |
5,920 条 |
|
Batch size |
32 |
|
训练轮数 |
7 轮,每轮 185 step |
|
参数更新次数 |
1,295 次 |
|
学习率 / 梯度裁剪 |
0.001 / 1.0 |
|
训练环境 |
Mac 上的 PyTorch + Apple MPS |
每一轮训练结束后都会保存一份 checkpoint,也就是某一时刻的模型参数快照。不同轮次会接受同一套评测,最终依据综合表现选择,而不直接把最后一轮当成最好的一轮。
07
为什么量化必须从训练阶段开始
如果把全部权重都用 FP32 保存,也就是每个数值使用 32 位浮点数,模型权重大约需要 29.9 MiB,已经超过这块板子的可用空间。量化的作用,就是用更少的位数表达权重和中间数值。
当前板端使用 Q4 权重和 int8 激活:Q4 用大约 4 位表示一个权重,int8 用 8 位整数表示计算过程中的中间值。权重主体因此压缩到约 3.86 MiB,加入 Tokenizer、词表、形状信息和校验信息后,完整模型包为 4,338,384 字节,约 4.14 MiB。
量化会引入误差,所以我们没有等模型训练完再一次性压缩,而是在训练时同时观察三条数值路径:
高精度路径
用 FP32 观察模型本身是否学会。
Q4 权重路径
让模型提前适应低比特权重带来的误差。
部署近似路径
使用 Q4 权重与 int8 激活,尽量靠近板端计算。
这种做法属于量化感知训练。它让模型在学习知识的同时,也学习怎样在低精度计算下保持答案稳定。
训练还会关注正确答案与错误答案之间的分数间隔。假设正确答案得分为 10.01,错误答案为 10.00,表面上虽然选对了,但只要量化误差稍微变化,结果就可能翻转。我们把目标间隔设为 0.5,让正确答案不只是“刚好领先”,而是留出更可靠的安全空间。
08
怎样让模型分清相似问题,并证明它真的学会
小模型常见的问题不是完全不会,而是把相似问题混在一起。例如,“你是谁”“你会什么”“这个问题不属于你的范围”都可能使用相似的词,但需要走向不同答案。
因此,我们把训练样本分成六种语义角色:身份、能力、需要澄清、超出范围、当前开发板事实和日常问候;每种角色再覆盖直接、委婉、口语化和带上下文等四种表达风格。训练时会同时观察这些分组,避免某一类表现很好、另一类却被掩盖。
把注意力放在答案真正分叉的地方
完整答案可能有很多相同的开头,真正决定答案类别的往往只是前几个关键 token。我们会找到能够唯一识别某个答案的最短前缀,并重点检查模型在这个“分叉点”上是否足够确定。
同时,评测不能只把正确答案强行喂给模型。真实生成时,模型需要沿着自己已经生成的前缀继续走。训练和检查中会从可到达的正确前缀出发,观察下一步预测,尽量缩小“训练时会做,真正生成时走偏”的差距。
用不同数据回答不同问题
|
数据集合 |
它回答的问题 |
|
训练数据 |
模型怎样更新参数 |
|
选择集(480 条) |
七轮训练中,哪一轮更值得继续检查 |
|
独立审计集(480 条) |
模型是否只适应了选择集 |
|
公开验证集(1,146 条) |
最终统一观察完整回答、量化一致性和语义分组表现 |
当前开发模型在 1,146 条公开验证问题上,高精度路径完整回答正确 1,001 条;Q4 路径和部署近似路径各正确 996 条。41 项质量检查通过 34 项,但七轮中还没有一轮同时满足全部条件。
这组结果把问题进一步缩小到了少量身份与歧义问题的分流、个别量化差异、答案结束标记的稳定性,以及部分数据组无法同时达标。下一轮训练因此有了明确目标:针对这些薄弱点补强,而不是继续盲目增加轮数。
09
从 PyTorch 到 ESP32,中间还缺一整条工程链
电脑上训练成功,只说明得到了一组参数。要让模型真正运行在 ESP32 上,还需要把训练资产、数值规则、C 语言运行时、固件和交互界面接成一条能够互相校验的链路。
产品知识与问答数据
▼
Tokenizer 与模型训练
▼
Q4 量化与模型包
▼
ESP32 C 语言运行时
▼
USB 逐 token 返回
▼
本地网页显示
模型包。板端读取的不是一份裸权重文件,而是一个完整资产包,其中包含 Tokenizer、输出词表映射、Q4 权重、张量形状和 SHA-256 身份校验。训练、导出、固件和运行时会核对资产身份,只有四个环节完全一致,系统才允许继续工作。
C 语言运行时。它负责中文 Tokenizer、模型包验证、Q4 矩阵计算、int8 激活、Transformer 前向计算、KV cache、逐 token 生成、结束判断和 UTF-8 安全输出。KV cache 会保存前面 token 已经算过的注意力结果,避免生成每个新 token 时全部重算。
内存分工。Flash 适合保存大量只读权重,并通过内存映射直接访问;PSRAM 容量较大,适合中间状态和较大的临时缓冲;内部 SRAM 更快,留给当前计算热点、控制结构和小型高频缓冲。模型能否稳定运行,不只取决于总大小,还取决于每一类数据被放在哪里、活多久。
固件与网页。固件负责装载模型、管理内存、接收 USB 文本并调用运行时。电脑端的串口工具和本地网页只转发问题、显示逐 token 结果与设备状态,不包含模型、Tokenizer、固定答案表或云端生成逻辑。这样测到的能力才真正属于板上的模型。
10
这套方法还能用在哪里
如果要把这条路线迁移到另一块板、另一个产品或另一类任务,真正需要重新设计的通常有四部分:
01知识边界:设备必须知道什么,又明确不处理什么。
02训练数据:怎样把可靠事实扩展成真实问法、语义对照和可检查答案。
03模型预算:根据 Flash、PSRAM、速度和任务复杂度决定词表、层数、宽度和上下文。
04部署链路:让 Python、导出工具、C 语言运行时、固件和真板测试遵守同一套格式与数值规则。
真正可复用的是这条完整闭环:先限定需求,再整理知识;用可检查的数据从随机参数开始训练;在训练阶段考虑量化;用相互隔离的数据评测;最后把同一套 Tokenizer、模型和数值规则搬到芯片上验证。
小芯片上的模型能力,最终由任务边界、数据、模型结构、训练目标和部署环境共同决定。
这块 ESP32 上的模型还在继续改进,但从知识整理、随机初始化训练、Q4 量化、C 语言推理,到 USB 真板问答和本地网页体验,完整路径已经被实际跑通。接下来要做的,是沿着已经暴露出来的具体问题继续提高质量,让“可以运行”一步步走向“稳定、可复现、可以正式交付”。